


프롬프트 작성
실제로 AI를 쓰는 질문과 작업.
보낼 때와 똑같이 프롬프트를 추가하세요. 벤치마크당 최대 200개입니다. 하나씩 붙여 넣거나, JSONL, JSON 또는 CSV로 묶음을 가져오거나, 템플릿에서 시작하세요.
나만의 AI 벤치마크를 만드세요. 프롬프트를 추가하고, 관심 있는 모델 전체에서 실행한 뒤 응답을 평가하고, 공유할 수 있는 리더보드를 게시하세요.
무료 체험 포함 신용카드 필요 없음 프롬프트는 비공개로 유지됩니다
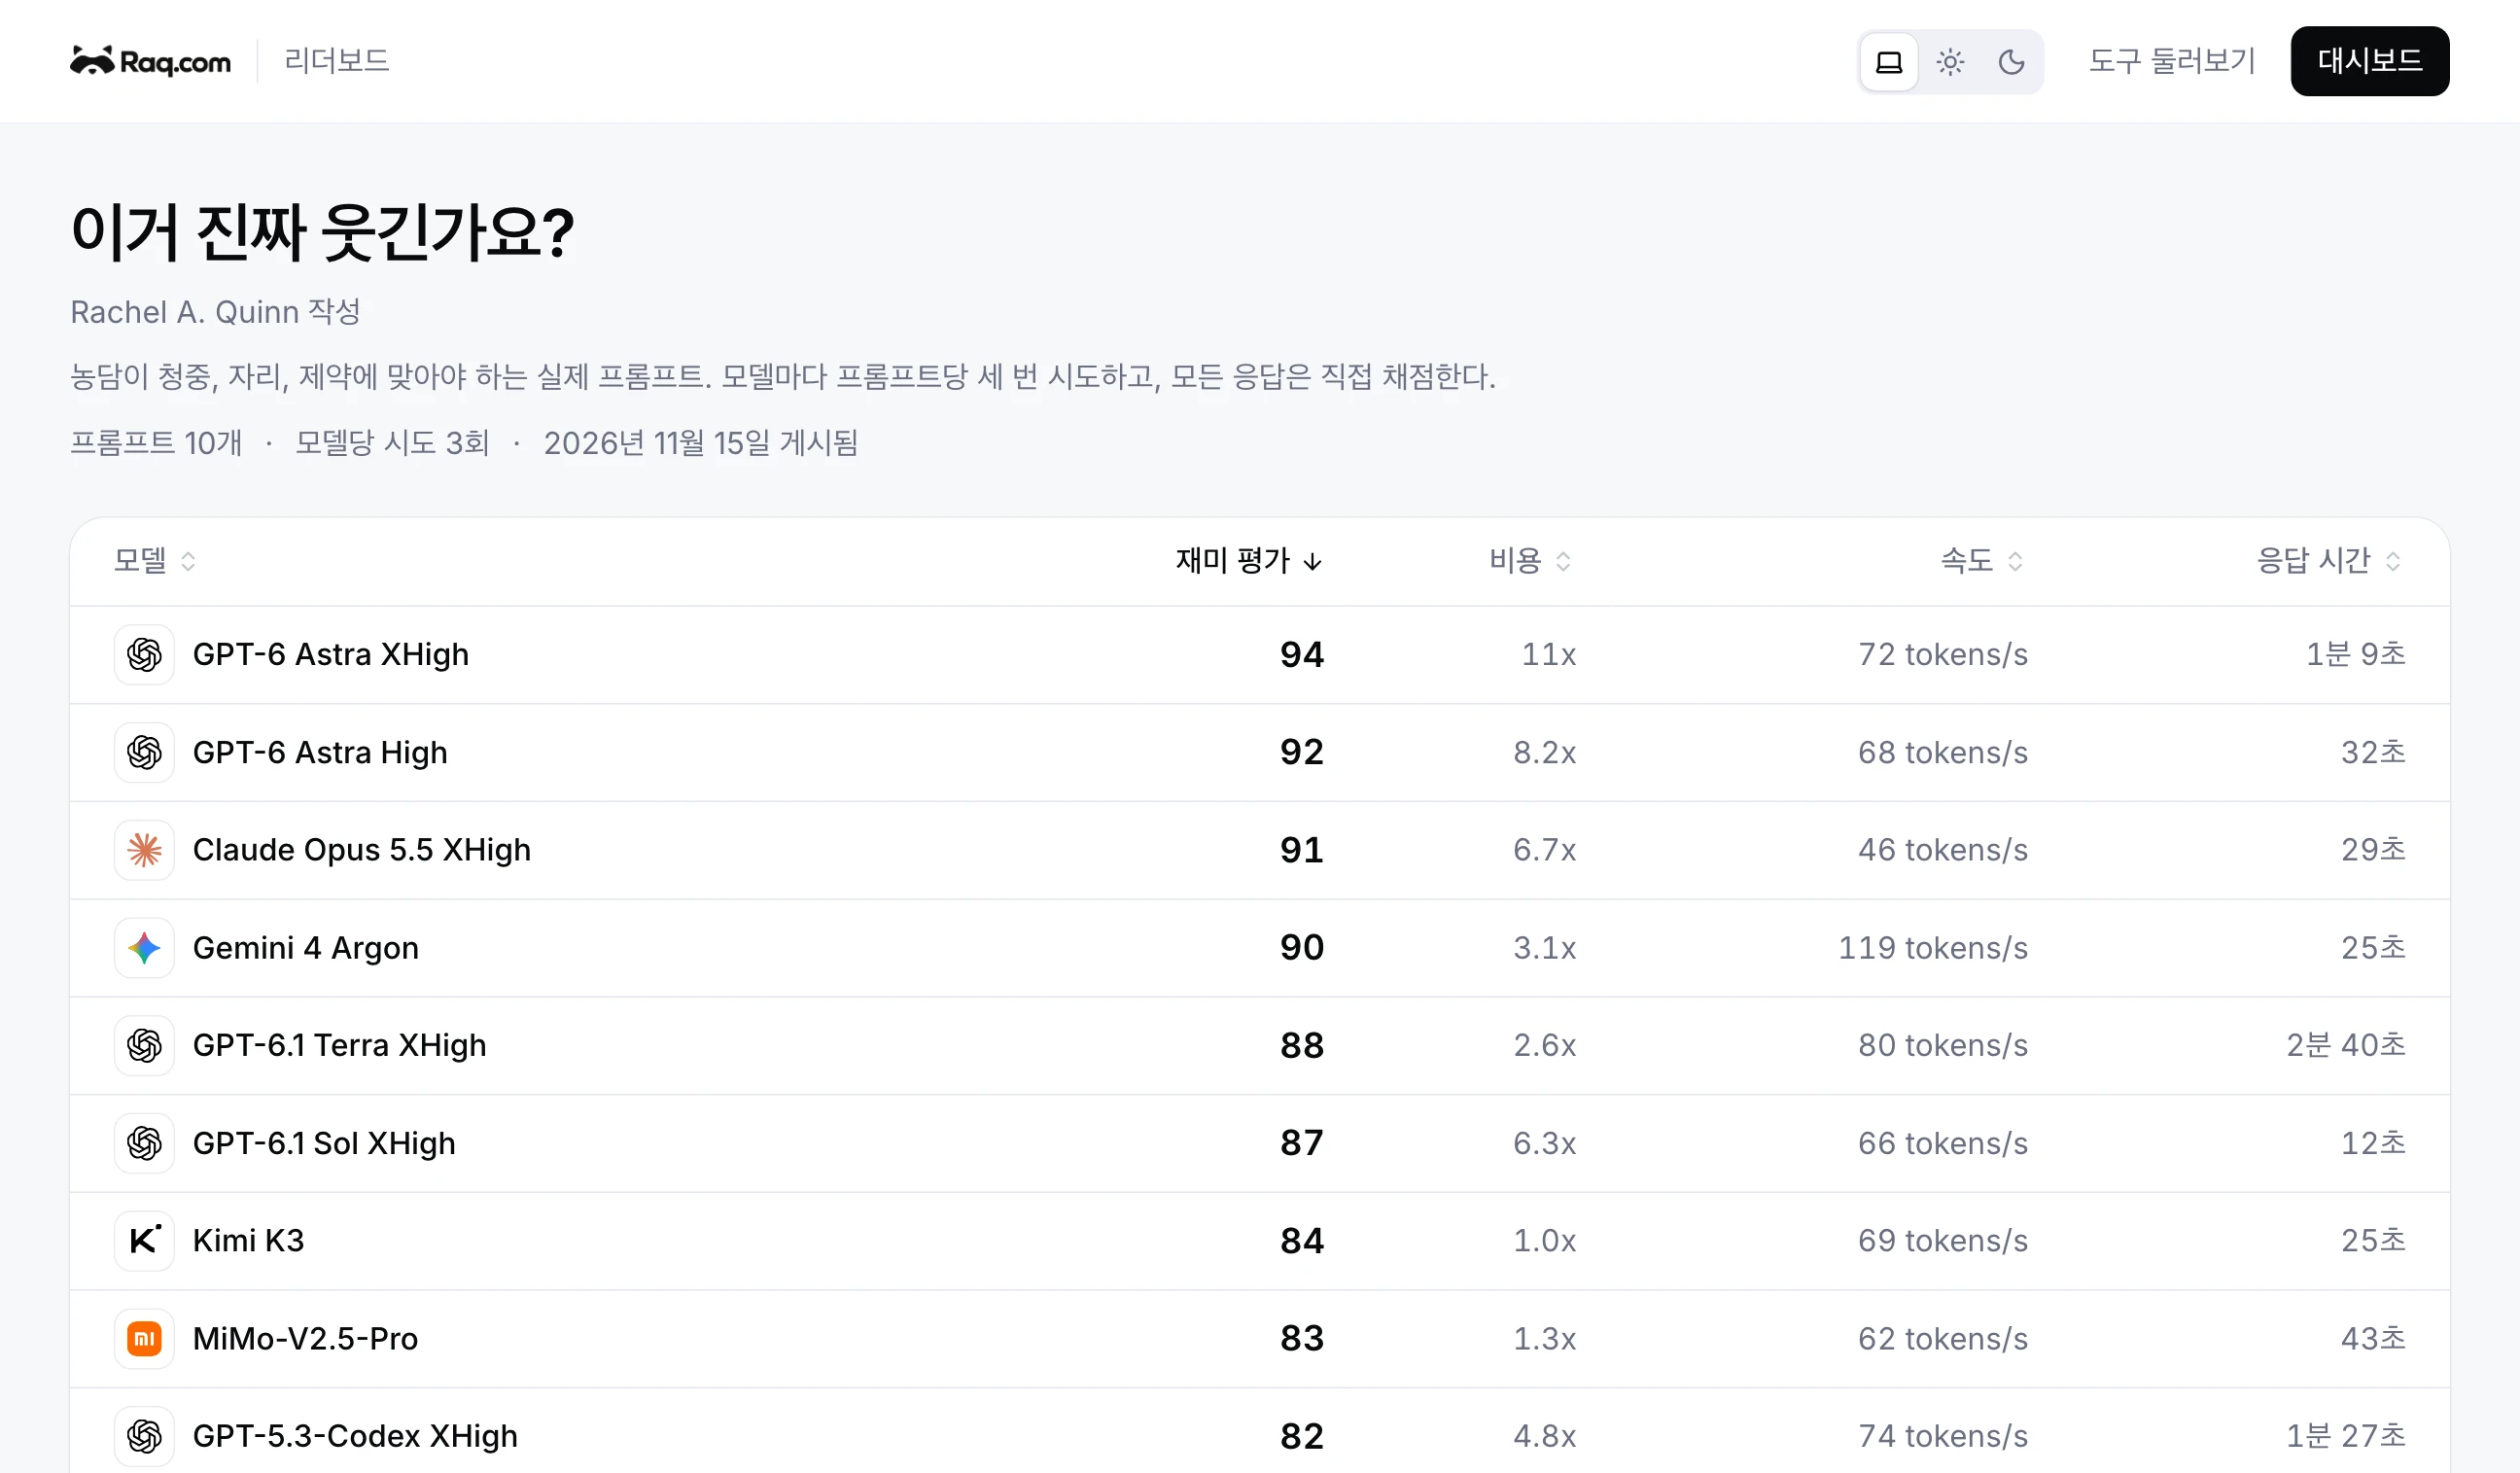
실제로 중요한 프롬프트 목록을 저장하고, 신뢰하는 기준 모델을 고른 뒤, 비교할 새 후보 모델을 추가하세요. 각 모델은 프롬프트당 최대 10번 시도할 수 있으며, 모든 응답에 별점을 매기면 Raq.com이 점수를 평균 내어 고유 URL에 공개 리더보드 표를 만듭니다. 다른 사람의 벤치마크를 신뢰할 필요가 없습니다. 업무에 맞는 벤치마크를 직접 만드세요.
Claude, ChatGPT Work, Grok Bot 및 커넥터를 지원하는 모든 AI 앱에서 작동합니다. 내 앱 연결
고객 질문으로 이 AI 모델들을 비교하세요.
같은 질문을 AI 벤치마커로 실행하고, 팀이 평가할 수 있도록 응답을 모아 정리하겠습니다.
실제로 AI를 쓰는 질문과 작업.
보낼 때와 똑같이 프롬프트를 추가하세요. 벤치마크당 최대 200개입니다. 하나씩 붙여 넣거나, JSONL, JSON 또는 CSV로 묶음을 가져오거나, 템플릿에서 시작하세요.
직접 매기는 별, 기대 답변 또는 AI 심사.
실행 후 답을 직접 평가하거나, 기대하는 답을 주고 확인하거나, 기준을 작성해 심사 모델이 각 답에 점수를 매기게 하세요. 심사 모델이 준 점수는 바꿀 수 있습니다.
한 번 실행에 최대 25개 모델.
회사, 크기, 추론 수준을 섞고, 신뢰하는 모델을 매번 실행되는 기준으로 두세요. 각 프롬프트는 최대 열 번 반복해 답의 안정성을 볼 수 있습니다.
모든 모델의 점수, 비용, 속도.
어떤 모델이 점수가 가장 높고, 가장 저렴하고, 가장 빠른지 본 뒤 답변을 열어 읽으세요. 표를 리더보드로 게시하거나 링크로 실행을 공유할 수 있습니다.
실행마다 모델을 호출하기 전에 들어갈 AI 사용량을 보여 주고, 비용이 그 한도를 넘으면 상한이 멈춥니다.
벤치마크를 매일, 매주 또는 매월 실행하거나, 맞는 새 모델이 나오면 그 모델만으로 저절로 시작하게 하세요.
실행을 이름이 표시된 공개 페이지에 올리거나, 링크, 비밀번호, 종료일로 실행 하나를 공유하세요.
Promptfoo 구성을 벤치마크로 가져오거나 다시 내보내고, API 키로 자체 스크립트에서 실행을 시작하세요.